JEV 是什么
Jev 是 TypeSafe AI 的第一个公开模型,2026 年 9 月 15 日发布。Jev 背后这家公司的创始人是 Diogo Almeida——前 OpenAI 研究员,RLHF 的共同发明人之一——在拿出任何产品之前就融了四千万美元。这份履历是 Jev 第一周就被大量讨论的原因。而让讨论持续下去的,是 Jev 在形态上跟所有被拿来和它比较的模型都不一样。
你用过的每一个聊天模型都是靠写字回答的,Jev 不是。让它给一张工单分类,它会写一句包含分类结果的话,然后你的代码去解析这句话、校验它、并处理它写歪的情况。Jev 把这一整层拿掉了。你在调用之前就把候选答案定好,Jev 从里面返回一个,是类型化的值,带着概率。没有东西需要解析,因为 Jev 根本不产出文字。
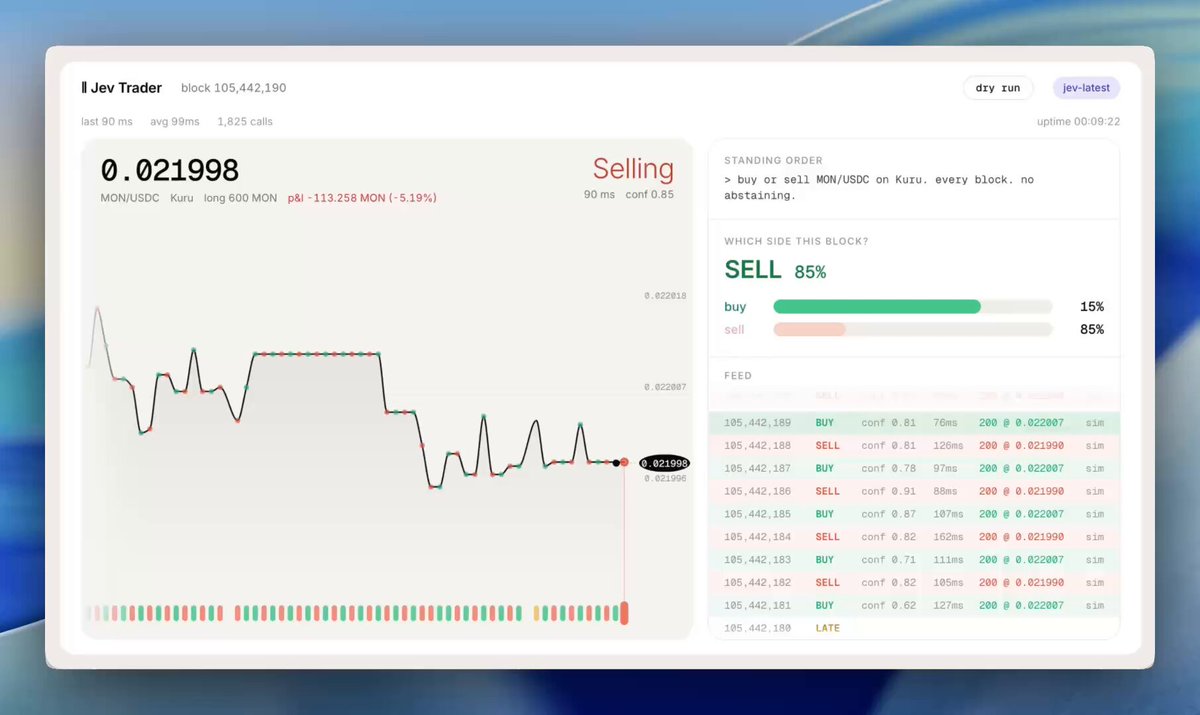
Jev 这么做的直接后果是快和便宜。一次 Jev 调用落在 70 到 500 毫秒之间,价格是每百万输入 token 0.042 美元,输出免费。同样的分类交给聊天模型要好几秒,成本高一到两个数量级。当同一个判断每天要跑一万次,这个差距就不再是细节,而是这个功能能不能做的前提。
还有必要说清 Jev 不是什么,因为媒体上的对比经常是驴唇不对马嘴。Jev 不是一个更小更便宜的 GPT,不是蒸馏出来的模型,也不是微调。Jev 是为另一件事训练的另一套架构,用需要写字的任务去评价 Jev,就像用尺子去称重。
SYSTEM ONE 模型是什么
这个名字借自丹尼尔·卡尼曼。系统二是慢的、刻意的、费力的;系统一是快的、自动的、直觉的。市面上所有推理模型在设计上都属于系统二——思维链本身就是卖点,想得越久表现往往越好。Jev 是另一边。System One 模型不把推演摊开给你看,Jev 看一眼状态,然后给答案。
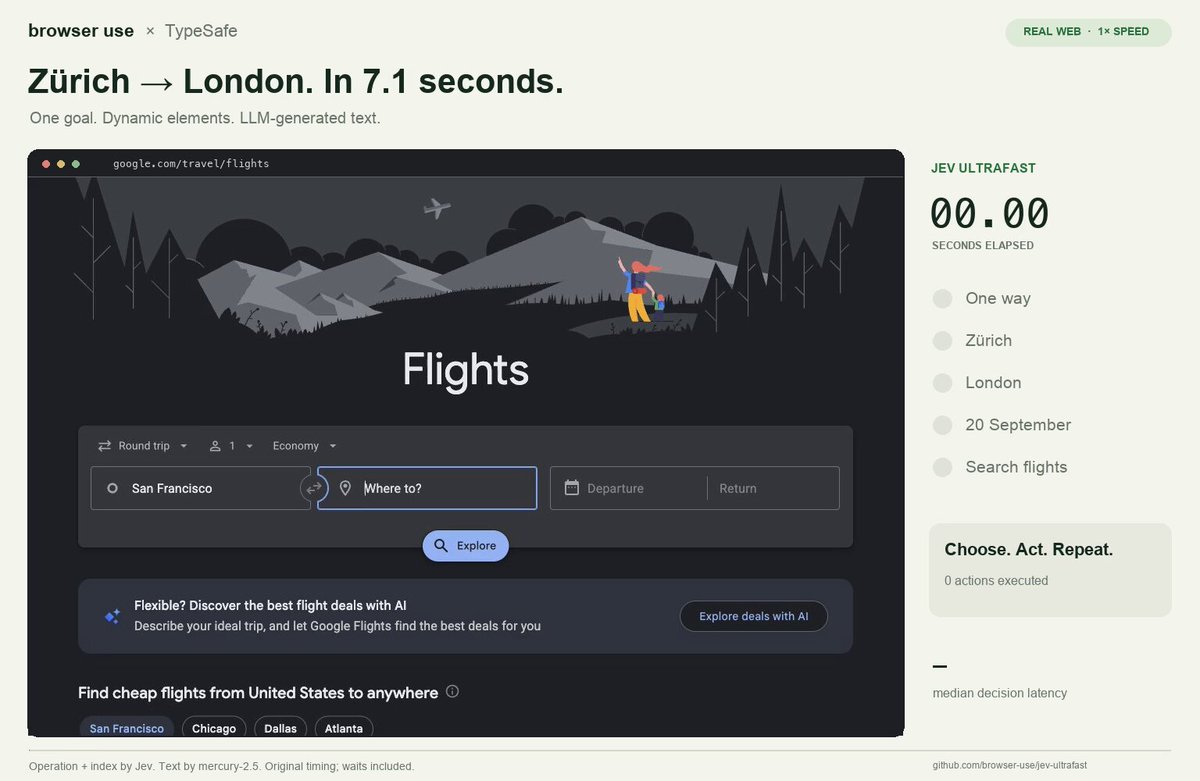
架构上这意味着 Jev 不是语言模型,尽管 Jev 是个 transformer。Jev 没有自回归解码,所以不存在逐 token 生成的等待。一个并行采样器把请求里的所有答案一次性产出。这就是为什么对同一份状态问 Jev 六个问题,耗时和问一个差不多——这个特性直接决定了大家围绕 Jev 的设计方式。
Jev 的训练方法叫 RLCD,Reinforcement Learning for Calibrated Decisions。RLHF 优化的是人类偏好,RLVR 优化的是可验证答案,而 RLCD 优化的是概率的诚实度:Jev 说自己有七成把握时,它应该真的有七成时候是对的。校准本身就是这个模型的卖点,也正是因为有校准,Jev 给的置信度才值得你在代码里设一个阈值。
这个说法并非人人买账。一种常见的批评是:Jev 本质上就是个零样本分类器,套了前沿模型的外衣;把一个不会写代码、不会聊天、连一句话都写不出的东西叫前沿模型,是在借用它没挣到的信誉。这个质疑值得认真对待。但它解释不了的是,为什么发布一周之内就有几百位开发者把 Jev 接到了真实问题上——而记录这件事正是本站存在的理由。
JEV 怎么工作
一次 Jev 请求只有两个部分。**状态**是这次 Jev 判断所依赖的上下文——一张工单、一个页面、一段 diff、一个候选段落、一帧游戏画面——以文本或结构化对象传入。**问题**是你想让它判断什么,每个问题都要事先声明自己的类型和允许的答案。
Jev 在一次并行运算里把所有问题都答完,把结果交还给你的代码。接下来是代码擅长的事:读 Jev 给的置信度、套阈值、做权限校验、执行副作用。Jev 永远不执行动作。这个分工就是整个设计,每一个好的 Jev 接入都遵守它——模型提供判断,程序保留控制权。
这同时也是 Jev 安全性的来源。因为 Jev 不能调用工具、不能写参数、不能产生副作用,一个错误的 Jev 答案的影响半径,被限制在你的代码拿这个数字做了什么上。这跟给 agent 一套工具然后指望 prompt 能兜住,是完全不同的风险结构。
CHOICE、SCORE 和 NOUL
Jev 只有三种提问类型,这就是 Jev 全部的接口面积。这个限制本身就是设计:你没法问 Jev 任何一个你还没把答案范围画出来的问题。
- CHOICE
- 从你定义的一组选项里让 Jev 挑一个。Jev 会返回每个选项各自的概率,外加一个总体置信度——你看到的不只是赢家,还有第二名离得多近。单个 Choice 问题最多能带 255 个选项;更深的分类体系靠问题串联来做,而不是堆一个巨大的列表。
- SCORE
- 按你描述的有序档位让 Jev 给状态打分——平静、担忧、愤怒;轻微、实质、严重。Jev 返回一个连续值、背后的分布,以及置信度。因为档位是描述出来的而不是编号的,一个 Score 问题读起来像评分细则,而不是一个随手拍的 1 到 10。
- NOUL
- 问一个关于状态的判断句是否成立,Jev 返回它为真的概率。大多数防护栏都是用这个类型搭的——这次工具调用会不会造成破坏、这段引文能不能支撑这个论断、agent 是不是真的做完了。有些 SDK 把同一个类型写成 type: "boolean"。
from typesafe_sdk import Choice, Noul, Score

questions = {
    "intent":      Choice(instructions="Why is this customer writing in?",
                          criteria={"bug": "...", "billing": "...", "other": "..."}),
    "is_urgent":   Noul(instructions="Does the message state time pressure?"),
    "frustration": Score(instructions="How frustrated does the customer sound?",
                         criteria=["Calm", "Concerned", "Angry"]),
}
因为 Jev 是并行求值的,常见的设计手法是多问几个用不上的,让代码去丢弃不相关的答案。TypeSafe 自己的 playbook 把这叫投机式扇出,它之所以划算,是因为 Jev 的输出定价为零。
JEV 到底返回什么
每一个 Jev 答案都带着校准过的置信度,而这个数字是整个响应里最有用的东西。它让你的代码能表达一个裸标签表达不了的策略:0.8 以上自动执行,0.5 到 0.8 之间执行但打标抽检,低于 0.5 不执行、转人工。阈值写在你的代码里,你可以推敲它、测试它、改它,不需要重训 Jev。
Jev 也不可能产生类型错误。答案是从你给的 schema 里抽出来的,所以不存在格式错误的 JSON、不存在凭空多出来的枚举值、不需要在解析器外面套重试循环。TypeSafe 报告 Jev 的结构化输出错误率和工具调用错误率都是 0%——跟准确率那些数字不同,这一条是架构决定的,不是训练出来的。
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: {
    refunded: {
      type: 'boolean',
      instructions: 'Was a refund issued?',
    },
  },
});

if (result.refunded > 0.8) closeTicket();
JEV 多少钱
Jev 的价格是每百万输入 token 0.042 美元,输出免费——TypeSafe 的原话是「便宜到不值得计量」,当输出只是几个浮点数而不是一篇文章时,这话确实好说。Jev 所有接入路径都没有免费额度,第一次 Jev 调用和之后每一次一样计费。
具体点说:每月五十万次判断、每次输入 800 token,用 Jev 不到二十美元。同样的量交给 Jev 在基准里对标的那一档通用模型,是几百到上千美元。我们的「Jev 对比文本大模型」页面有一个可以拖的计算器,你能看到自己的量级落在哪里。
有一项 Jev 的参数是真的说不清。Jev 的上下文窗口,各家说法不一。Vercel 的模型页写的上下文窗口是 32,000 token,而好几篇媒体报道写的是 64k。我们没能从一手文档里把它定下来,所以这里标注冲突,而不是替你选一个。
JEV 的基准成绩怎么读
有两个数字跟着 Jev 到处跑:快 193.6 倍、便宜 444.6 倍。它们是真实测量值,但来自一段 Jev 玩 Doom 的录像演示,不是基准测试套件。套件的数字没那么好看,但有用得多。
| 模型 | 准确率 | 单次成本 | 延迟 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4s |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1s |
| GPT-5.6 Sol准确率最高 | 74.1% | $0.0836 | 23.3s |
| Opus 5 | 73.1% | $0.1761 | 37.8s |
先看准确率那一列,再看成本。Jev 在准确率上没赢。在 TypeSafe 自己的 711 个用例套件里,Jev 与 GPT-5.6 Terra 打平,比 GPT-5.6 Sol 和 Opus 5 低 5 到 6 个百分点;在最弱的子项——发票处理上,差距比汇总数字显示的大得多。
Jev 赢的是比值,而这个比值非常可观:拿到跟 Terra 差不多的准确率,只花大约 1/76 的成本、1/25 的延迟。如果你的判断能接受 Terra 那个档次的准确率——大多数路由、分诊、过滤类判断都能,因为不确定的那些本来就会被人或更大的模型复核——那 Jev 不是妥协,而是用低两个数量级的代价拿到同一个答案。
如果你的判断需要 Sol 或 Opus 那个档次的准确率,而且没法用置信度阈值兜住,那 Jev 就不是答案,省多少钱都改变不了这一点。
关于 Jev 的任何基准说法都该附两句提醒,包括这一页上的:Jev 的权重没有公开,上面那张表是卖这个模型的人自己打的分,没有别人复现过;而所谓准确率,衡量的是与模型生成的参考答案的一致度,跟客观正确不是一回事。针对 Jev 的独立评测现在是有的——列在下面,而且它们对 Jev 也谈不上客气。
对 Jev 的独立第三方评测
上面那张表是 TypeSafe 自己做的。下面这四项对 Jev 的评测不是:每一项都由公司外的人跑出来,样本写明,原始数字公开。其中三项是预注册的——方案在发出第一次 Jev 调用之前就冻结并取了哈希,事后没法再改判定标准。这四项加起来,是目前能拿到的、关于 Jev 实际表现的最硬的证据。
PubMedQA 的是非题上,Jev 得 69.0,Gemini 3.8 Flash 得 73.0——Jev 在统计意义上与六个大模型里最好的那个打平,价格是它的 1/28。Banking77 的多选题上,Jev 得 67.8,Gemini 得 74.1,Jev 这次没能追平。HelpSteer2 的评分题上,包括 Jev 在内没有一个模型明显赢过按标签基准率瞎猜。Jev 每一个判断的概率都按 CC BY 4.0 公开了,谁都可以自己复算。
样本: 7 models × 3 task types × 300 items × 5 runs = 31,500 scored decisions
对 Jev「校准过」这个说法给出的是一半一半的结论。CLINC150 上成立:Jev 的置信度与实际正确率每一档差距都在 2.5 个百分点以内(ECE 0.0204)。Banking77 上不成立(ECE 0.0936)——Jev 声称 0.86 的置信度,实际只对了 67%,是系统性的过度自信。类型安全这一条则完全站住:8576 次 Jev 响应里,没有一次答出给定选项之外的东西。这是「Jev 不会幻觉」这句话唯一被独立验证过的部分。
样本: Banking77 3,080 items + CLINC150 5,496 items
给 Jev 的 state 用西班牙语写而不是英语,Jev 在 XNLI、PAWS-X、MASSIVE、Belebele 上一律掉 3.0 到 6.4 个百分点,校准误差大约翻倍(XNLI 从 0.057 到 0.101)。可自动放行的比例(p ≥ 0.9)从 72.2% 降到 63.4%。而把给 Jev 的 instructions 改成西班牙语,什么变化都没有——所以结论是 state 跟着数据走,instructions 一律留英文。
样本: 3,200 paired human-labelled items, 19,200 calls, jev-1.13.0 version-pinned
Jev 的校准误差是 0.1472,GPT-4.1 是 0.2393;Jev 的账单是 4.02 美元,GPT-4.1 大约 136 美元,约三十四分之一。更值得记住的是关于提问设计的那条:同样问 Jev,把一个是非题写成 Noul 而不是两选项的 Choice,对结果的影响比换模型还大。也就是说用 Jev 的时候,问题怎么定型比选哪个模型更要紧。
样本: 300 synthetic respondents × 108 questions, Twin-2K-500
什么时候别用 JEV
下面这些不是边角案例,它们就是 Jev 这个模型的形状。知道它们,基本上就是「Jev 接得好」和「Jev 悄悄退化」之间的全部差别。
它什么都写不了
写不了工具调用的参数,写不了回复,写不了摘要。Jev 返回的是一个判断,永远不是文字。任何需要产出语句的流程,仍然需要一个文本模型。
链式推理会让它变差
当一个问题需要好几步相互依赖的推导时,准确率会明显下降。第三方独立实测发现,数学计算、日期推算、间接引用这三类都会削弱它。
只吃文本和结构化状态
没有视觉、音频、视频输入。截图理解和图像审核目前都不在它的形状之内。
非英文的 state 会掉准确率
一次针对 3200 条人工标注样本的预注册配对审计发现:把 state 用西班牙语写而不是英语,准确率掉 3.0 到 6.4 个百分点,校准误差大约翻倍。而把 instructions 改成西班牙语,什么变化都没有。如果你的数据不是英文的,先自己测一遍再决定信不信它。
它可能很自信地答错
它编不出你没给的选项——这才是「不会幻觉」的真实含义。但它完全可能以很高的置信度选错,而且不会附带任何自然语言解释。
判断标准归结成一句话:高频、重复、共享状态、且所有可能答案在调用前就已知的判断,交给 Jev。其余的仍然需要文本模型——实际上大多数系统是两个一起跑,Jev 当便宜的闸门,挡在贵的那个前面。
怎么开始用 JEV
TypeSafe 在 2026 年 9 月 20 日撤掉了 Jev 的等待名单,所以现在最直的路就是去控制台开个号,还自带 5 美元额度。想走网关也行,价格一样:Vercel 的 AI Gateway 通过 AI SDK 的 experimental evaluate 路径把 Jev 暴露为 typesafe-ai/jev;Cloudflare Workers AI 和 OpenRouter 也都提供 Jev。官方 SDK 是 Python 的 typesafe-sdk 和 JavaScript 的 @typesafe-ai/sdk,LangChain、Pydantic AI 以及一批 MCP server 都已经原生支持 Jev。
判断 Jev 适不适合你的问题,最快也最诚实的办法是看看别人已经把它指向了哪里。本站的开源项目索引和决策模式页面加起来,基本覆盖了 Jev 接入的大部分形态。