JEV とは何か
Jev は TypeSafe AI の最初の公開モデルで、2026 年 9 月 15 日に出た。この会社を作ったのは Diogo Almeida —— 元 OpenAI の研究者で、RLHF の共同発明者の一人 —— で、製品が一つもない段階で 4000 万ドルを調達している。この経歴が、Jev が最初の一週間で大量に語られた理由だ。そして Jev の話題が続いた理由は別にある。Jev は、比較対象に持ち出されるどのモデルとも形が違う。
これまで触ってきたチャットモデルは、どれも文章を書くことで答えを出していた。Jev は違う。問い合わせを分類させれば、チャットモデルは分類結果を含む一文を書き、あなたのコードはその一文を解析し、検証し、書き損じた場合の処理まで用意することになる。Jev はこの層をまるごと取り除く。Jev を呼び出す前に候補を決めておき、Jev はその中から一つを型のついた値として、確率つきで返す。Jev は文字列を生成しないのだから、解析するものが存在しない。
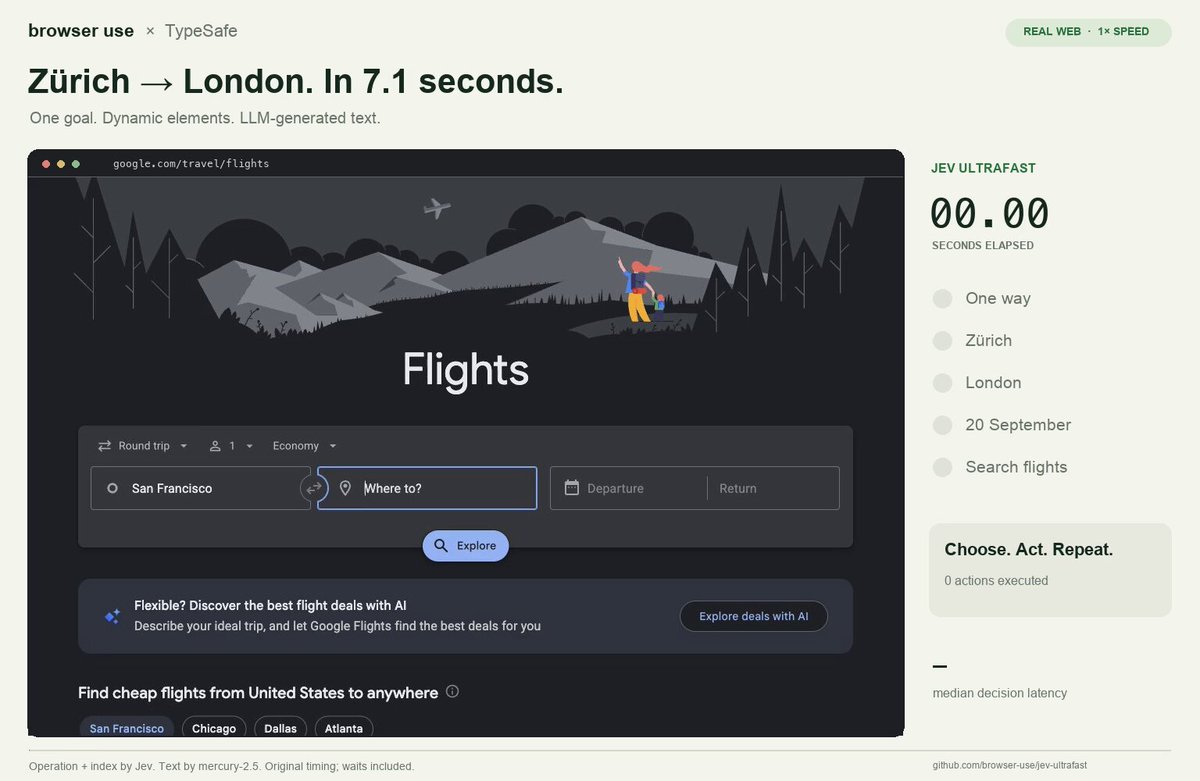
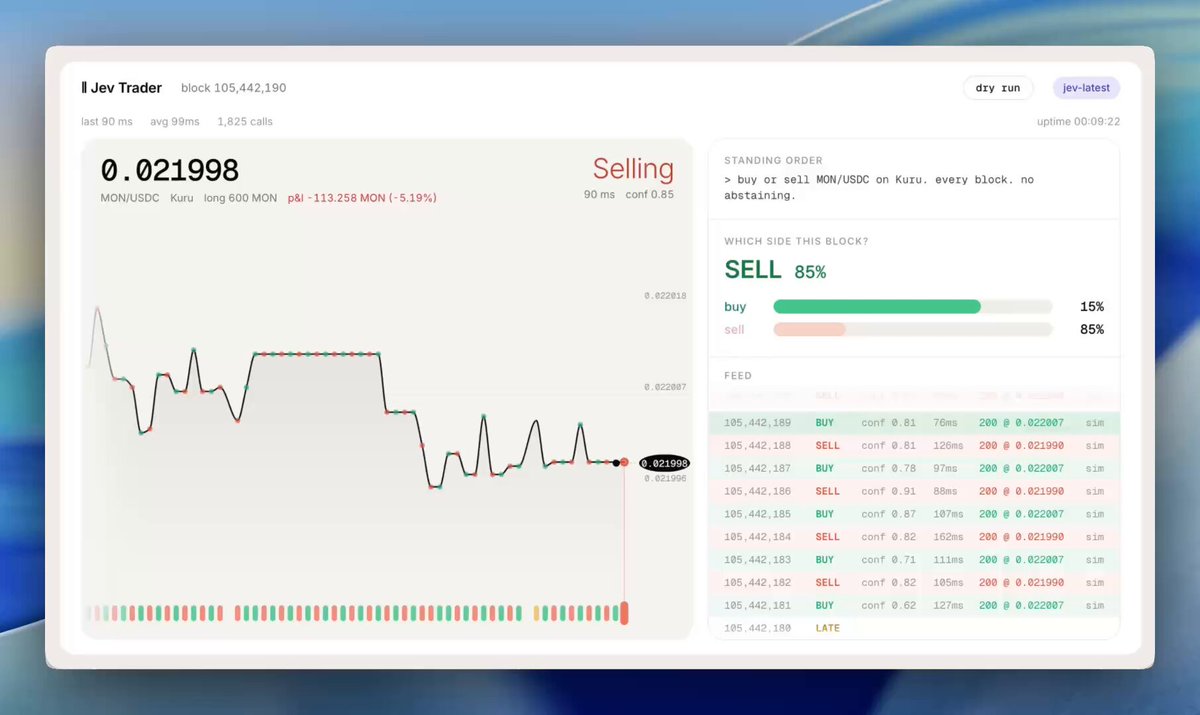
この Jev の設計が、そのまま速さと安さになる。1 回の Jev 呼び出しは 70〜500 ミリ秒、価格は入力 100 万トークンで 0.042 ドル、出力は無料。同じ分類をチャットモデルにやらせれば数秒かかり、費用は 1〜2 桁上がる。同じ判断を 1 日に 1 万回走らせるなら、Jev との差はもう細部ではなく、その機能を作れるかどうかの前提条件になる。
Jev が何ではないかも言っておいたほうがいい。世間に出回る Jev の比較は、しばしば噛み合っていない。Jev は小さくて安い GPT ではないし、蒸留モデルでもファインチューンでもない。Jev は別の目的のために訓練された別のアーキテクチャで、文章を書く課題で Jev を評価するのは、定規で重さを量るようなものだ。
SYSTEM ONE モデルとは
Jev の System One という呼び名は、ダニエル・カーネマンから来ている。システム 2 は遅く、意識的で、骨が折れる。システム 1 は速く、自動的で、直感的だ。いま出回っている推論モデルは設計上すべてシステム 2 側にいる —— 思考の連鎖そのものが売りで、長く考えるほど成績が上がる。Jev は反対側にいる。System One モデルは推論の過程を広げて見せない。Jev は状態を一目見て、答えを出す。
アーキテクチャで言えば、Jev は transformer ではあるが言語モデルではない。Jev には自己回帰デコードがないので、トークンを一つずつ生成する待ち時間が存在しない。Jev の並列サンプラーが、リクエスト内の答えを一度に吐く。同じ状態について Jev に六つ質問しても、一つのときとほとんど所要時間が変わらないのはこのためで、この性質が Jev まわりの設計のしかたを直接決めている。
Jev の訓練手法は RLCD、Reinforcement Learning for Calibrated Decisions と呼ばれている。RLHF が人間の好みを、RLVR が検証可能な答えを最適化するのに対し、RLCD が最適化するのは Jev の確率の正直さだ。Jev が 7 割だと言うとき、本当に 10 回中 7 回当たっていてほしい。較正そのものが Jev の売りであり、較正されているからこそ、Jev が返す確信度にコード側でしきい値を置く意味が出てくる。
この主張に全員が納得しているわけではない。よくある批判はこうだ —— Jev は結局のところフロンティアモデルの衣をまとったゼロショット分類器であって、コードも書けず会話もできず一文すら書けないものをフロンティアモデルと呼ぶのは、稼いでいない信用を借りている。この Jev への指摘は、真面目に扱う価値がある。ただしそれでは、公開から一週間で数百人の開発者が Jev を実務の問題に繋ぎ込んだ事実は説明できない —— それを記録しているのが、このサイトの存在理由でもある。
JEV はどう動くのか
Jev のリクエストは二つの部分しかない。**状態**は、その Jev の判断が依って立つ文脈だ —— 問い合わせ 1 件、ページ 1 枚、ディフ、検索で引いた段落、ゲームの 1 フレーム —— テキストか構造化オブジェクトとして渡す。**質問**は Jev に判断してほしいことで、一つひとつが自分の型と許される答えをあらかじめ宣言している。
Jev はすべての質問を一回の並列演算で解き、結果をコードに返す。そこから先は Jev ではなくコードの仕事になる。Jev の確信度を読み、しきい値をあて、権限を検査し、副作用を実行する。Jev は決して動作を実行しない。この分担が設計のすべてで、うまくいっている Jev の組み込みは例外なくこれを守っている —— モデルが判断を出し、プログラムが制御を握り続ける。
Jev の安全性もここから来ている。Jev はツールを呼べず、引数を書けず、副作用を起こせない。だから誤った Jev の答えの影響範囲は、その数字を受けてコードが何をしたかの中に閉じている。エージェントに道具一式を渡してプロンプトで抑え込むことを期待する構成と比べると、Jev はリスクの形そのものが違う。
CHOICE、SCORE、NOUL
Jev の質問型は三つだけで、これが Jev のインターフェースの全面積だ。この制約自体が設計になっている。答えの範囲をまだ描けていない問いは、そもそも Jev に投げられない。
- CHOICE
- こちらが定義した選択肢の中から Jev に一つ選ばせる。Jev は各選択肢の確率と、全体の確信度を返す —— Jev からは勝者だけでなく、二位がどれだけ迫っていたかも見える。1 つの Jev の Choice が持てる選択肢は最大 255 件。より深い分類体系は、巨大な一覧を積むのではなく Jev の質問を段に分けて作る。
- SCORE
- こちらが言葉で説明した順序つきの段階で、Jev に状態の点をつけさせる —— 平静・不安・激怒、軽微・実質的・重大。Jev は連続値と、その背後の分布と、確信度を返す。段階が番号ではなく説明で与えられるので、Jev の Score の質問は、採点基準の文書のように読める。適当な 1〜10 とは別物だ。
- NOUL
- 状態についての言明が成り立つかを聞き、Jev はそれが真である確率を返す。Jev で組むガードレールの大半はこの型でできている —— そのツール呼び出しは破壊的か、その引用は主張を支えているか、エージェントは本当に終わっているか。SDK によっては同じ型が type「boolean」として書かれている。
from typesafe_sdk import Choice, Noul, Score

questions = {
    "intent":      Choice(instructions="Why is this customer writing in?",
                          criteria={"bug": "...", "billing": "...", "other": "..."}),
    "is_urgent":   Noul(instructions="Does the message state time pressure?"),
    "frustration": Score(instructions="How frustrated does the customer sound?",
                         criteria=["Calm", "Concerned", "Angry"]),
}
Jev は並列に解くので、使わないかもしれない質問まで多めに投げ、関係なかった答えをコード側で捨てる書き方が定番になっている。TypeSafe 自身の playbook はこれを投機的ファンアウトと呼んでいる。成り立つのは、Jev の出力が無料だからだ。
JEV が実際に返すもの
Jev の答えには必ず較正された確信度がついてくる。そして、レスポンスの中でいちばん役に立つのはこの数字だ。裸のラベルでは書けない方針が、Jev のこの数字のおかげでコードに書ける。Jev の確信度が 0.8 以上なら自動実行、0.5〜0.8 は実行しつつ印をつけて抜き取り検査、0.5 未満は実行せず人に回す。しきい値は自分のコードの中にあるので、議論でき、テストでき、変えられる。Jev を再訓練する必要はない。
Jev は型エラーも起こしえない。Jev の答えは渡したスキーマから取り出されるので、壊れた JSON も、どこにもない列挙値も、パーサーの外側に巻くリトライループも存在しない。TypeSafe は Jev の構造化出力エラー率とツール呼び出しエラー率をどちらも 0% と報告している。精度の数字と違って、この一項目は Jev の訓練の成果ではなくアーキテクチャの帰結だ。
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: {
    refunded: {
      type: 'boolean',
      instructions: 'Was a refund issued?',
    },
  },
});

if (result.refunded > 0.8) closeTicket();
JEV の価格
Jev の価格は入力 100 万トークンあたり 0.042 ドル、出力は無料 —— TypeSafe の表現では「計測する価値もないほど安い」。Jev の出力が記事ではなく浮動小数点数の数個なら、たしかにそう言える。Jev にはどの経路にも無料枠がなく、最初の Jev 呼び出しから以降と同じように課金される。
具体的にすると、月 50 万回の判断、1 回あたり入力 800 トークンで、Jev の請求は 20 ドルに届かない。同じ量をベンチマークで Jev の比較対象になっている汎用モデルに投げれば、数百から数千ドルになる。「Jev とテキスト LLM の比較」ページに動かせる計算機を置いてあるので、自分の規模がどこに落ちるかはそこで見てほしい。
ひとつだけ、Jev について本当に確定できていない項目がある。Jev のコンテキストウィンドウだ。Vercel のモデルページは Jev を 32,000 トークンと書いているが、複数の報道は 64k としている。一次資料で確定できなかったので、ここでは食い違いとして明示しておく。勝手にどちらかを選ぶことはしない。
JEV のベンチマークの読み方
Jev にはどこへ行っても二つの数字がついて回る。193.6 倍速い、444.6 倍安い。どちらも実測値ではあるが、出どころは Jev が Doom を遊ぶ録画デモであって、ベンチマークスイートではない。スイート側の Jev の数字はもっと地味で、そのぶん役に立つ。
| モデル | 正答率 | 1 件あたりのコスト | レイテンシ |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4s |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1s |
| GPT-5.6 Sol最高精度 | 74.1% | $0.0836 | 23.3s |
| Opus 5 | 73.1% | $0.1761 | 37.8s |
先に精度の列を見て、それから Jev のコストを見る。Jev は精度では勝っていない。TypeSafe 自身の 711 ケースのスイートで Jev は GPT-5.6 Terra と並び、GPT-5.6 Sol と Opus 5 には 5〜6 ポイント届かない。Jev がいちばん弱い項目である請求書処理では、その差は総合値が示すよりずっと大きい。
Jev が勝っているのは比率で、その比率はかなりのものだ。Jev は Terra とほぼ同じ精度を、およそ 76 分の 1 のコストと 25 分の 1 の遅延で取っている。自分の判断が Terra の水準の精度で足りるなら —— ルーティングや振り分け、フィルタ系の判断はたいてい足りる。確信の持てないものはどのみち人か大きいモデルに回るからだ —— この場合の Jev は妥協ではなく、二桁安い代価で同じ答えを得る手段になる。
Sol や Opus の水準が必要で、しかも確信度のしきい値で受け止めきれないなら、Jev は答えではない。Jev がいくら安くてもそこは変わらない。
Jev のベンチマークに関するどの主張にも、このページのものも含めて、注意書きを二つ添えるべきだ。Jev の重みは公開されておらず、上の表は Jev を売っている当人が採点している。誰かが再現したわけではない。そして Jev の精度と呼ばれているものは、モデルが生成した参照解との一致度であって、客観的な正しさとは別物だ。Jev への第三者評価は、いまはある。下に並べた。そちらも Jev に甘くはない。
Jev の第三者による評価
上の表は TypeSafe 自身のものだ。ここから下にある四つの Jev 評価は違う。いずれも社外の人間が、標本を明示したうえで走らせ、生の数字を公開している。うち三つは事前登録されている。最初の Jev 呼び出しより前に手順を凍結してハッシュを取っているので、あとから判定基準を動かすことはできない。この四つが、いま手に入る Jev の実力についていちばん硬い証拠になる。Jev に不利な結論も削らずそのまま載せている。
Jev と LLM に同じ設問を当てた独立の比較だ。PubMedQA の Yes/No では Jev が 69.0、Gemini 3.8 Flash が 73.0。Jev は統計的には大規模言語モデル六つの最上位と互角で、価格は 28 分の 1 だ。Banking77 の多肢選択では Jev 67.8 に対し Gemini 74.1 で、ここでは Jev は追いつけていない。HelpSteer2 の採点課題では、Jev を含めてどのモデルもラベルの基礎率で当てずっぽうに答えるのをはっきり上回れなかった。Jev の判断ごとの確率はすべて CC BY 4.0 で公開されているので、誰でも自分で数え直せる。
標本: 7 models × 3 task types × 300 items × 5 runs = 31,500 scored decisions
Jev は「較正されている」という主張に対する結論は半々だった。CLINC150 では Jev の確信度と実際の正答率の差がどの区間でも 2.5 ポイント以内に収まった(ECE 0.0204)。Banking77 では成立しない(ECE 0.0936)。Jev は確信度 0.86 と称しておいて、実際に正しかったのは 67% で、系統的な自信過剰だった。一方、型の安全性は完全に保たれた。8,576 回の Jev 応答のうち、与えた選択肢の外を答えたものは一つもない。「Jev は幻覚を起こさない」という言い方のうち、第三者に裏を取られているのはこの部分だけだ。
標本: Banking77 3,080 items + CLINC150 5,496 items
Jev に渡す state を英語ではなくスペイン語で書くと、Jev の正答率は XNLI・PAWS-X・MASSIVE・Belebele のいずれでも 3.0〜6.4 ポイント落ち、較正誤差はおよそ倍になった(XNLI で 0.057 → 0.101)。自動で通せる割合(p ≥ 0.9)は 72.2% から 63.4% へ下がる。対して Jev への instructions をスペイン語にしても、変化は何も出なかった。つまり state はデータの言語に従い、instructions は英語のままにしておくのがよい。
標本: 3,200 paired human-labelled items, 19,200 calls, jev-1.13.0 version-pinned
較正誤差は Jev が 0.1472、GPT-4.1 が 0.2393。請求額は Jev が 4.02 ドル、GPT-4.1 がおよそ 136 ドルで、34 分の 1 ほどだった。それより憶えておく価値があるのは問いの設計の話だ。同じ Jev に訊くのでも、Yes/No の設問を二択の Choice ではなく Noul として尋ねると、モデルを取り替えるより結果が動いた。Jev を使ううえでは、どのモデルを選ぶかより問いをどう型に落とすかのほうが効く。
標本: 300 synthetic respondents × 108 questions, Twin-2K-500
JEV を使うべきでない場面
以下は例外的なケースではなく、Jev というモデルの形そのものだ。これを知っているかどうかが、うまく入った Jev と、静かに劣化していく Jev の差のほぼすべてになる。
文章は一切書けない
ツール引数も、返信も、要約も書けない。Jev が返すのは判断であって、文章ではない。言葉を出力する工程があるなら、テキストモデルは依然として必要になる。
連鎖する推論で精度が落ちる
依存関係のある推論を何段も重ねる問いでは、正答率がはっきり下がる。第三者の実測では、計算・日付の演算・間接参照のいずれも弱点として現れている。
入力はテキストと構造化状態のみ
画像・音声・動画は受け付けない。スクリーンショットの理解や画像モデレーションは、現時点では守備範囲の外にある。
英語以外の state は正答率を削る
人手でラベルを付けた 3,200 件による事前登録の対照監査では、state を英語ではなくスペイン語で書くと正答率が 3.0〜6.4 ポイント落ち、較正誤差はおよそ倍になった。一方 instructions をスペイン語にしても何も変わらなかった。手元のデータが英語でないなら、信じる前に自分で測ったほうがいい。
自信を持って間違えることがある
渡していない選択肢を勝手に作ることはできない——「ハルシネーションを起こさない」の正確な意味はこれだけだ。高い確信度のまま誤った選択肢を選ぶことはあり、そのとき理由は一切返ってこない。
判断基準は一文にまとまる。高頻度で、繰り返しがあり、状態を共有していて、答えの候補が呼び出し前にすべて分かっている判断は Jev に渡す。それ以外にはテキストモデルが要る。実際のところ多くのシステムは両方を走らせていて、Jev は高いモデルの手前に置かれた安い関門として働いている。
JEV の始め方
TypeSafe は 2026 年 9 月 20 日に Jev の順番待ちを撤廃した。いちばん近い入口はコンソールでアカウントを作ることで、5 ドル分のクレジットも付いてくる。同じ価格で Jev を出しているゲートウェイもある。Vercel の AI Gateway は AI SDK の experimental evaluate 経由で Jev を typesafe-ai/jev として公開しているし、Cloudflare Workers AI と OpenRouter でも Jev は使える。Jev の公式 SDK は Python の typesafe-sdk と JavaScript の @typesafe-ai/sdk。LangChain、Pydantic AI、そして複数の MCP サーバーがすでに Jev をネイティブに扱う。
Jev が自分の問題に合うかを見極める最短で最も正直な方法は、他の人がすでに Jev をどこに向けたのかを見ることだ。このサイトの Jev のオープンソース索引と、Jev の判断パターンのページを合わせれば、Jev の組み込み方のかなりの部分が並んでいる。