JEV란 무엇인가
Jev는 TypeSafe AI의 첫 공개 모델이고 2026년 9월 15일에 나왔다. 이 회사를 만든 사람은 Diogo Almeida —— 전 OpenAI 연구원이자 RLHF 공동 발명자 중 한 명 —— 이고, 제품이 하나도 없는 단계에서 4000만 달러를 모았다. 이 이력이 Jev가 첫 주에 그토록 많이 회자된 이유다. 그리고 Jev에 대한 이야기가 계속된 이유는 따로 있다. Jev는 비교 대상으로 끌려 나오는 어떤 모델과도 생김새가 다르다.
지금까지 써 온 챗 모델은 전부 글을 써서 답을 냈다. Jev는 다르다. 문의를 분류시키면 챗 모델은 분류 결과가 담긴 문장을 쓰고, 당신의 코드는 그 문장을 파싱하고, 검증하고, 잘못 쓴 경우까지 처리해야 한다. Jev는 이 층을 통째로 걷어낸다. Jev를 부르기 전에 후보를 정해 두면 Jev는 그중 하나를 타입이 붙은 값으로, 확률과 함께 돌려준다. Jev는 문자열을 만들지 않으니 파싱할 것이 존재하지 않는다.
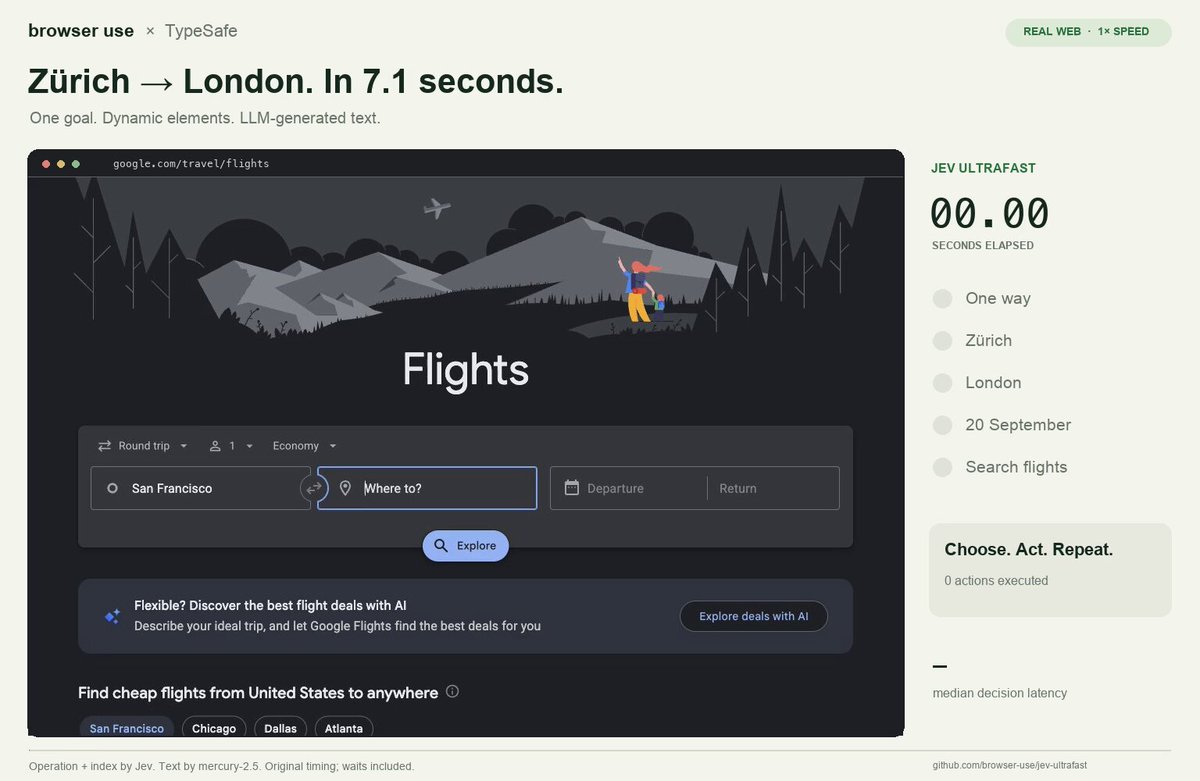
이 Jev의 설계가 그대로 속도와 가격이 된다. Jev 호출 한 번은 70~500밀리초, 가격은 입력 100만 토큰에 0.042달러, 출력은 무료다. 같은 분류를 챗 모델에게 시키면 몇 초가 걸리고 비용은 한두 자릿수 올라간다. 같은 판단을 하루에 1만 번 돌린다면 Jev와의 이 차이는 더 이상 디테일이 아니라, 그 기능을 만들 수 있느냐 없느냐의 전제 조건이 된다.
Jev가 무엇이 아닌지도 짚어야 한다. 세간에 도는 Jev 비교는 자주 엇나간다. Jev는 작고 싼 GPT가 아니고, 증류 모델도 파인튜닝도 아니다. Jev는 다른 목적을 위해 훈련된 다른 아키텍처이고, 글을 써야 하는 과제로 Jev를 평가하는 것은 자로 무게를 재는 일과 같다.
SYSTEM ONE 모델이란
Jev의 System One이라는 이름은 대니얼 카너먼에게서 왔다. 시스템 2는 느리고 의식적이며 품이 든다. 시스템 1은 빠르고 자동적이며 직관적이다. 지금 나와 있는 추론 모델은 설계상 전부 시스템 2 쪽에 있다 —— 사고의 연쇄 자체가 상품이고, 오래 생각할수록 성적이 오른다. Jev는 반대편에 있다. System One 모델은 추론 과정을 펼쳐 보이지 않는다. Jev는 상태를 한 번 보고 답을 낸다.
아키텍처로 말하면 Jev는 transformer이긴 해도 언어 모델이 아니다. Jev에는 자기회귀 디코딩이 없으니 토큰을 하나씩 만들어 내는 대기 시간이 존재하지 않는다. Jev의 병렬 샘플러가 요청 안의 답을 한꺼번에 뱉는다. 같은 상태에 대해 Jev에게 여섯 개를 물어도 하나를 물을 때와 걸리는 시간이 거의 같은 이유가 이것이고, 이 성질이 Jev를 둘러싼 설계 방식을 그대로 결정한다.
Jev의 훈련 기법은 RLCD, Reinforcement Learning for Calibrated Decisions라고 불린다. RLHF가 사람의 선호를, RLVR이 검증 가능한 답을 최적화한다면 RLCD가 최적화하는 것은 Jev 확률의 정직함이다. Jev가 7할이라고 말할 때 실제로 열 번 중 일곱 번 맞기를 바라는 것이다. 보정 자체가 Jev의 상품이고, 보정되어 있기 때문에 Jev가 돌려주는 확신도에 코드가 임계값을 걸 의미가 생긴다.
이 주장에 모두가 동의하는 것은 아니다. 흔한 비판은 이렇다 —— Jev는 결국 프론티어 모델의 옷을 입은 제로샷 분류기이고, 코드도 못 쓰고 대화도 못 하고 한 문장도 못 쓰는 것을 프론티어 모델이라 부르는 건 벌지 않은 신용을 빌려 쓰는 일이다. Jev를 향한 이 지적은 진지하게 다룰 값어치가 있다. 다만 그것으로는, 공개 일주일 만에 수백 명의 개발자가 Jev를 실무 문제에 붙였다는 사실이 설명되지 않는다 —— 그것을 기록하는 것이 이 사이트의 존재 이유이기도 하다.
JEV는 어떻게 도는가
Jev 요청은 부분이 둘뿐이다. **상태**는 그 Jev 판단이 딛고 서는 맥락이다 —— 문의 한 건, 페이지 한 장, diff, 검색으로 끌어온 문단, 게임의 한 프레임 —— 텍스트나 구조화된 객체로 넘긴다. **질문**은 Jev가 판단해 주기를 바라는 것이고, 하나하나가 자기 타입과 허용되는 답을 미리 선언한다.
Jev는 모든 질문을 한 번의 병렬 연산으로 풀고 결과를 코드에 돌려준다. 거기서부터는 Jev가 아니라 코드의 일이다. Jev의 확신도를 읽고, 임계값을 걸고, 권한을 검사하고, 부수 효과를 실행한다. Jev는 절대 동작을 실행하지 않는다. 이 분담이 설계의 전부이고, 잘 굴러가는 Jev 연동은 예외 없이 이것을 지킨다 —— 모델이 판단을 내고, 프로그램이 통제를 쥔다.
Jev의 안전성도 여기서 나온다. Jev는 도구를 부를 수 없고, 인자를 쓸 수 없고, 부수 효과를 낼 수 없다. 그래서 틀린 Jev 답의 영향 범위는 그 숫자를 받아 코드가 무엇을 했는지 안에 닫혀 있다. 에이전트에게 도구 한 벌을 쥐여 주고 프롬프트로 눌러 두기를 기대하는 구성과 비교하면, Jev는 위험의 모양 자체가 다르다.
CHOICE, SCORE, NOUL
Jev의 질문 유형은 셋뿐이고, 이것이 Jev 인터페이스의 전체 면적이다. 이 제약 자체가 설계다. 답의 범위를 아직 그리지 못한 물음은 애초에 Jev에게 던질 수 없다.
- CHOICE
- 이쪽이 정의한 선택지 중에서 Jev에게 하나를 고르게 한다. Jev는 선택지별 확률과 전체 확신도를 돌려준다 —— Jev에게서는 승자뿐 아니라 2위가 얼마나 바짝 붙었는지도 보인다. Jev의 Choice 하나가 가질 수 있는 선택지는 최대 255개다. 더 깊은 분류 체계는 거대한 목록을 쌓는 대신 Jev 질문을 단으로 나눠 만든다.
- SCORE
- 이쪽이 말로 설명한 순서 있는 단계로 Jev에게 상태의 점수를 매기게 한다 —— 평온·우려·분노, 경미·실질·심각. Jev는 연속값과 그 뒤의 분포, 그리고 확신도를 돌려준다. 단계가 번호가 아니라 설명으로 주어지기 때문에 Jev의 Score 질문은 채점 기준 문서처럼 읽힌다. 대충 잡은 1~10과는 다른 물건이다.
- NOUL
- 상태에 대한 진술이 성립하는지 묻고, Jev는 그것이 참일 확률을 돌려준다. Jev로 짜는 가드레일의 대부분이 이 유형으로 되어 있다 —— 이 도구 호출은 파괴적인가, 이 인용은 주장을 떠받치는가, 에이전트는 정말 끝냈는가. SDK에 따라서는 같은 유형이 type「boolean」으로 적혀 있다.
from typesafe_sdk import Choice, Noul, Score

questions = {
    "intent":      Choice(instructions="Why is this customer writing in?",
                          criteria={"bug": "...", "billing": "...", "other": "..."}),
    "is_urgent":   Noul(instructions="Does the message state time pressure?"),
    "frustration": Score(instructions="How frustrated does the customer sound?",
                         criteria=["Calm", "Concerned", "Angry"]),
}
Jev는 병렬로 풀기 때문에, 안 쓸지도 모르는 질문까지 넉넉히 던지고 관계없던 답은 코드에서 버리는 방식이 정석이 됐다. TypeSafe 자신의 playbook은 이것을 투기적 팬아웃이라고 부른다. 성립하는 이유는 Jev의 출력이 무료이기 때문이다.
JEV가 실제로 돌려주는 것
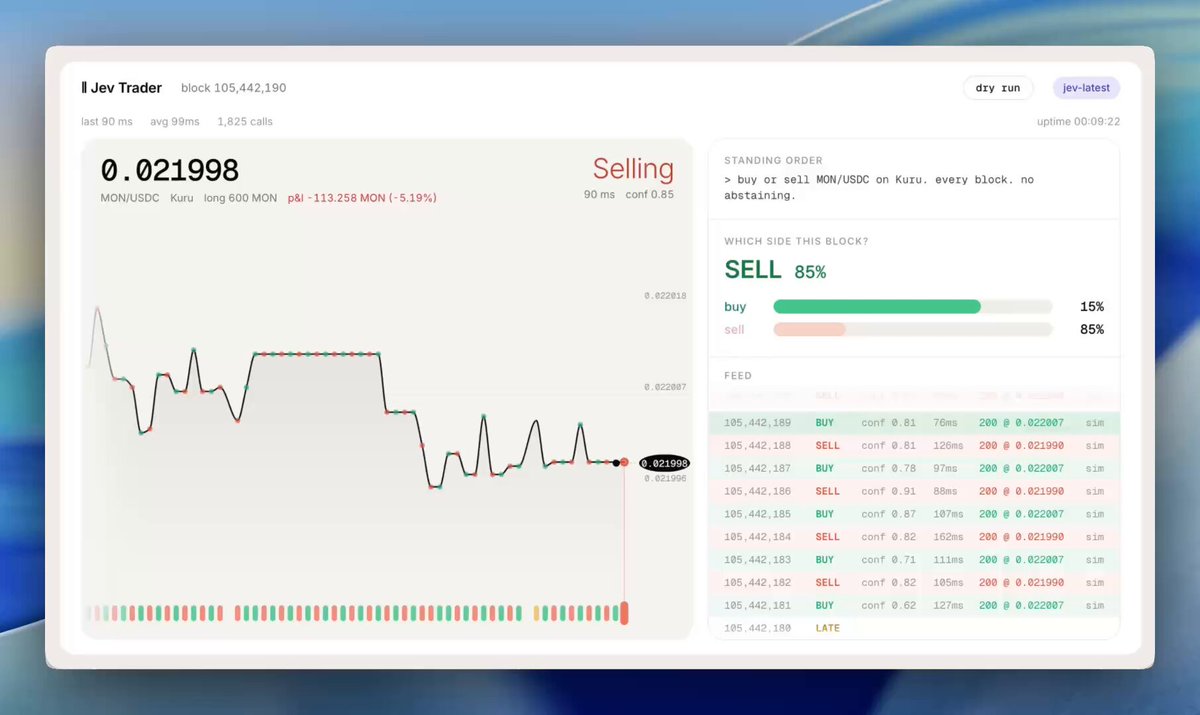
Jev의 답에는 반드시 보정된 확신도가 따라온다. 그리고 응답 중에서 가장 쓸모 있는 것이 이 숫자다. 맨 레이블로는 못 쓰는 정책이 Jev의 이 숫자 덕분에 코드에 적힌다. Jev의 확신도가 0.8 이상이면 자동 실행, 0.5~0.8이면 실행하되 표시해 두고 표본 검사, 0.5 미만이면 실행하지 않고 사람에게 넘긴다. 임계값은 내 코드 안에 있으니 따져 볼 수 있고, 테스트할 수 있고, 바꿀 수 있다. Jev를 재훈련할 필요가 없다.
Jev는 타입 오류도 낼 수 없다. Jev의 답은 넘겨준 스키마에서 뽑히기 때문에 깨진 JSON도, 어디에도 없는 열거값도, 파서 바깥에 감는 재시도 루프도 존재하지 않는다. TypeSafe는 Jev의 구조화 출력 오류율과 도구 호출 오류율을 모두 0%로 보고한다. 정확도 숫자와 달리 이 한 항목은 Jev 훈련의 성과가 아니라 아키텍처의 귀결이다.
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: {
    refunded: {
      type: 'boolean',
      instructions: 'Was a refund issued?',
    },
  },
});

if (result.refunded > 0.8) closeTicket();
JEV의 가격
Jev의 가격은 입력 100만 토큰당 0.042달러, 출력은 무료다 —— TypeSafe의 표현으로는 「계측할 값어치도 없을 만큼 싸다」. Jev의 출력이 글이 아니라 부동소수점 몇 개라면 확실히 그렇게 말할 수 있다. Jev는 어느 경로에도 무료 구간이 없고, 첫 Jev 호출부터 그다음과 똑같이 과금된다.
구체적으로 하면, 월 50만 번 판단에 한 번당 입력 800토큰이면 Jev 청구액은 20달러에 못 미친다. 같은 양을 벤치마크에서 Jev의 비교 대상이 되는 범용 모델에 던지면 수백에서 수천 달러가 된다. 「Jev와 텍스트 LLM 비교」 페이지에 움직이는 계산기를 뒀으니, 자기 규모가 어디에 떨어지는지는 거기서 보면 된다.
딱 하나, Jev에 대해 정말 확정하지 못한 항목이 있다. Jev의 컨텍스트 윈도다. Vercel의 모델 페이지는 Jev를 32,000토큰으로 적어 두었지만 여러 보도는 64k라고 쓴다. 1차 자료로 확정하지 못했으므로 여기서는 충돌로 명시해 둔다. 대신 골라 주지는 않는다.
JEV 벤치마크 읽는 법
Jev에는 어디를 가나 숫자 두 개가 따라붙는다. 193.6배 빠르다, 444.6배 싸다. 둘 다 실측값이긴 하지만 출처는 Jev가 Doom을 하는 녹화 데모이지 벤치마크 스위트가 아니다. 스위트 쪽 Jev의 숫자는 훨씬 수수하고, 그만큼 쓸모가 있다.
| 모델 | 정확도 | 건당 비용 | 지연 시간 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4s |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1s |
| GPT-5.6 Sol정확도 1위 | 74.1% | $0.0836 | 23.3s |
| Opus 5 | 73.1% | $0.1761 | 37.8s |
정확도 열을 먼저 보고 그다음에 Jev의 비용을 본다. Jev는 정확도에서 이기지 않았다. TypeSafe 자신의 711케이스 스위트에서 Jev는 GPT-5.6 Terra와 나란하고, GPT-5.6 Sol과 Opus 5에는 5~6포인트 못 미친다. Jev가 가장 약한 항목인 청구서 처리에서는 그 격차가 종합 수치가 보여 주는 것보다 훨씬 크다.
Jev가 이기는 것은 비율이고, 그 비율은 상당하다. Jev는 Terra와 거의 같은 정확도를 약 76분의 1 비용과 25분의 1 지연으로 가져간다. 내 판단이 Terra 수준의 정확도로 충분하다면 —— 라우팅이나 분류, 필터 계열 판단은 대개 충분하다. 확신이 서지 않는 건은 어차피 사람이나 큰 모델로 넘어가기 때문이다 —— 이 경우의 Jev는 타협이 아니라 두 자릿수 싼 값으로 같은 답을 얻는 수단이 된다.
Sol이나 Opus 수준이 반드시 필요하고 확신도 임계값으로도 받아 낼 수 없다면 Jev는 답이 아니다. Jev가 아무리 싸도 거기는 바뀌지 않는다.
Jev 벤치마크에 관한 어떤 주장에도, 이 페이지의 것까지 포함해서 주의 문구 둘을 달아야 한다. Jev의 가중치는 공개되지 않았고, 위 표는 Jev를 파는 당사자가 직접 채점한 것이라 남이 재현한 적이 없다. 그리고 Jev의 정확도라고 불리는 것은 모델이 만든 참조 답안과의 일치율이지 객관적인 정답률과는 다른 물건이다. Jev에 대한 제3자 평가는 이제 존재한다. 아래에 정리했고, 그쪽도 Jev에 후하지 않다.
Jev에 대한 제3자 평가
위 표는 TypeSafe가 직접 만든 것이다. 아래 네 건은 아니다. 모두 회사 바깥 사람이 표본을 밝히고 돌렸으며, 원자료를 공개했다. 그중 셋은 사전 등록이다. 첫 호출보다 먼저 절차를 얼리고 해시를 떠 두었으니, 나중에 판정 기준을 옮길 수 없다.
PubMedQA 예/아니오에서 Jev는 69.0, Gemini 3.8 Flash는 73.0이었다. 통계적으로는 대규모 언어 모델 여섯 중 최상위와 동률이고, 가격은 28분의 1이다. Banking77 다지선다에서는 Jev 67.8, Gemini 74.1. HelpSteer2 채점 과제에서는 Jev를 포함해 어느 모델도 라벨 기저율로 찍는 것을 뚜렷이 넘지 못했다. 판단마다의 확률은 전부 CC BY 4.0으로 공개돼 있다.
표본: 7 models × 3 task types × 300 items × 5 runs = 31,500 scored decisions
「보정되어 있다」는 주장에 대한 결론은 반반이었다. CLINC150에서는 확신도와 실제 정확도의 차이가 구간마다 2.5포인트 안에 들어왔다(ECE 0.0204). Banking77에서는 성립하지 않는다(ECE 0.0936). 확신도를 0.86이라 해 놓고 실제로 맞힌 것은 67%였다. 반면 타입 안전성은 온전히 지켜졌다. 8,576번의 응답 중 준 선택지 바깥을 답한 것은 한 건도 없다.
표본: Banking77 3,080 items + CLINC150 5,496 items
state를 영어가 아니라 스페인어로 쓰면 XNLI, PAWS-X, MASSIVE, Belebele 어디서나 정확도가 3.0~6.4포인트 떨어졌고, 보정 오차는 대략 두 배가 됐다(XNLI 0.057 → 0.101). 자동으로 통과시킬 수 있는 비율(p ≥ 0.9)은 72.2%에서 63.4%로 내려간다. 반대로 instructions를 스페인어로 바꾼 것은 아무 변화도 만들지 않았다.
표본: 3,200 paired human-labelled items, 19,200 calls, jev-1.13.0 version-pinned
보정 오차는 Jev가 0.1472, GPT-4.1이 0.2393이었다. 청구액은 4.02달러 대 약 136달러로 34분의 1 남짓이다. 더 기억할 만한 것은 질문 설계 쪽 교훈이다. 예/아니오 문항을 두 선택지의 Choice가 아니라 Noul로 물으면, 모델을 바꾸는 것보다 결과가 더 움직였다.
표본: 300 synthetic respondents × 108 questions, Twin-2K-500
JEV를 쓰지 말아야 할 때
아래는 예외적인 경우가 아니라 Jev라는 모델의 모양 그 자체다. 이걸 아느냐 모르느냐가 잘 들어간 Jev와 조용히 나빠지는 Jev의 차이 거의 전부가 된다.
글은 전혀 쓰지 못한다
도구 인자도, 답변도, 요약도 쓰지 못한다. Jev가 돌려주는 것은 판단이지 문장이 아니다. 말을 만들어야 하는 공정이 있다면 텍스트 모델은 여전히 필요하다.
연쇄 추론에서 정확도가 떨어진다
여러 단계가 서로 의존하는 질문에서는 정확도가 눈에 띄게 낮아진다. 제3자 실측에서 수식 계산, 날짜 연산, 간접 참조가 모두 약점으로 드러났다.
입력은 텍스트와 구조화 상태뿐
이미지, 오디오, 비디오는 받지 않는다. 스크린샷 이해나 이미지 모더레이션은 현재 사정권 밖이다.
영어가 아닌 state는 정확도를 깎는다
사람이 라벨을 붙인 3,200건으로 진행한 사전 등록 대조 감사에서, state를 영어가 아니라 스페인어로 쓰면 정확도가 3.0~6.4포인트 떨어지고 보정 오차는 대략 두 배가 됐다. 반면 instructions를 스페인어로 바꾼 것은 아무 차이도 만들지 않았다. 내 데이터가 영어가 아니라면, 믿기 전에 직접 재 보는 게 좋다.
확신에 차서 틀릴 수 있다
주지 않은 선택지를 지어내지는 못한다. '환각이 없다'는 말의 정확한 의미는 딱 거기까지다. 높은 확신도로 잘못된 선택지를 고르는 일은 있고, 그때 이유는 전혀 돌려주지 않는다.
판단 기준은 한 문장으로 모인다. 빈도가 높고, 반복되고, 상태를 공유하고, 답의 후보가 호출 전에 전부 알려진 판단은 Jev에게 넘긴다. 나머지에는 텍스트 모델이 필요하다. 실제로 많은 시스템이 둘을 함께 돌리고, Jev는 비싼 모델 앞에 놓인 싼 관문으로 일한다.
JEV 시작하는 법
TypeSafe는 2026년 9월 20일에 Jev 대기열을 없앴다. 가장 가까운 입구는 콘솔에서 계정을 만드는 것이고, 5달러 크레딧도 함께 들어온다. 같은 가격으로 쓸 수 있는 게이트웨이도 있다. Vercel의 AI Gateway는 AI SDK의 experimental evaluate 경로로 Jev를 typesafe-ai/jev로 노출하고, Cloudflare Workers AI와 OpenRouter에서도 Jev를 쓸 수 있다. Jev 공식 SDK는 파이썬의 typesafe-sdk와 자바스크립트의 @typesafe-ai/sdk다. LangChain, Pydantic AI, 그리고 여러 MCP 서버가 이미 Jev를 기본으로 다룬다.
Jev가 내 문제에 맞는지 가려내는 가장 빠르고 정직한 방법은, 다른 사람들이 이미 Jev를 어디에 겨눴는지 보는 것이다. 이 사이트의 Jev 오픈소스 색인과 Jev 판단 패턴 페이지를 합치면 Jev를 붙이는 방식의 상당 부분이 늘어서 있다.